TECHNOLOGY 技術紹介
ヒューマノイドの全身制御における強化学習アルゴリズムの比較(Fast-SAC vs PPO)およびSim2Sim検証
【※この記事は2026年6月時点の情報に基づきます。】
1.はじめに
近年、人型ロボットなどの全身制御(Whole-Body Control: WBC)において、様々なオープンソースのフレームワークが登場しています。
今回は、Amazon Farが公開している holosoma と、NVIDIA Labsによる ProtoMotions の2つの代表的なWBCフレームワークが採用している学習アルゴリズム( holosoma: Fast-SAC , ProtoMotions: PPO )の学習性能を評価しました。
具体的には、それぞれが採用している学習アルゴリズムのWBCに対する報酬の収束速度や目標軌道への追従誤差、エピソード時間の推移を比較し、さらに学習済みポリシーを用いたSim2Simでの実機想定シミュレーション検証までを行いました。
2.今回やったこと
◆使用ツール・環境: 各フレームワークの概要
■ holosoma (Amazon FAR Lab)
holosoma(ギリシャ語で「全身」を意味する)は、AmazonのFAR(Fundamental Automation Research)Labが公開した、ヒューマノイドロボット向けの総合的な強化学習フレームワークです。
【主な特徴】
・シミュレーションから実機への統合:
Isaac GymやMJWarp(MuJoCo)などのシミュレーション環境での学習から、実機(Unitree G1等)へのデプロイまでを同じ推論コード(holosoma-inference)でシームレスに行えるよう設計されています。
・対応タスク:
主に「Locomotion(速度トラッキング)」と、人間のモーションデータをロボットの関節角に変換して追従させる「Whole-Body Tracking」をサポートしています。
・アルゴリズム:
Fast-SACやPPOなどが組み込まれており、シミュレータ間のクロス評価(例:Isaac Gymで学習し、MuJoCoで評価)が容易な構造になっています。
■ ProtoMotions (NVIDIA Labs)
ProtoMotionsは、NVIDIA Labsが開発・公開している、デジタルヒューマンおよびヒューマノイド向けの物理シミュレーション駆動型モーション学習フレームワークです。
【主な特徴】
・ 並列計算:
NVIDIAのGPUおよびPhysX(Isaac Gymベース環境)の恩恵を最大限に活かし、大量のエージェントを同時に並列実行して高速に学習を進めることができます。
・ 高品質なモーション生成:
多様なモーションキャプチャデータ(AMASS等)をベースにした目標追従や、テキスト・空間コンストレイント(制約)に応じたインタラクティブで高品質な全身モーション生成に強みを持っています。
・ 設計思想:
リターゲティングや学習の「実験の回転数」をいかに早く回せるかに焦点を当てたアーキテクチャとなっています。
3. 検討方法(実験設定)
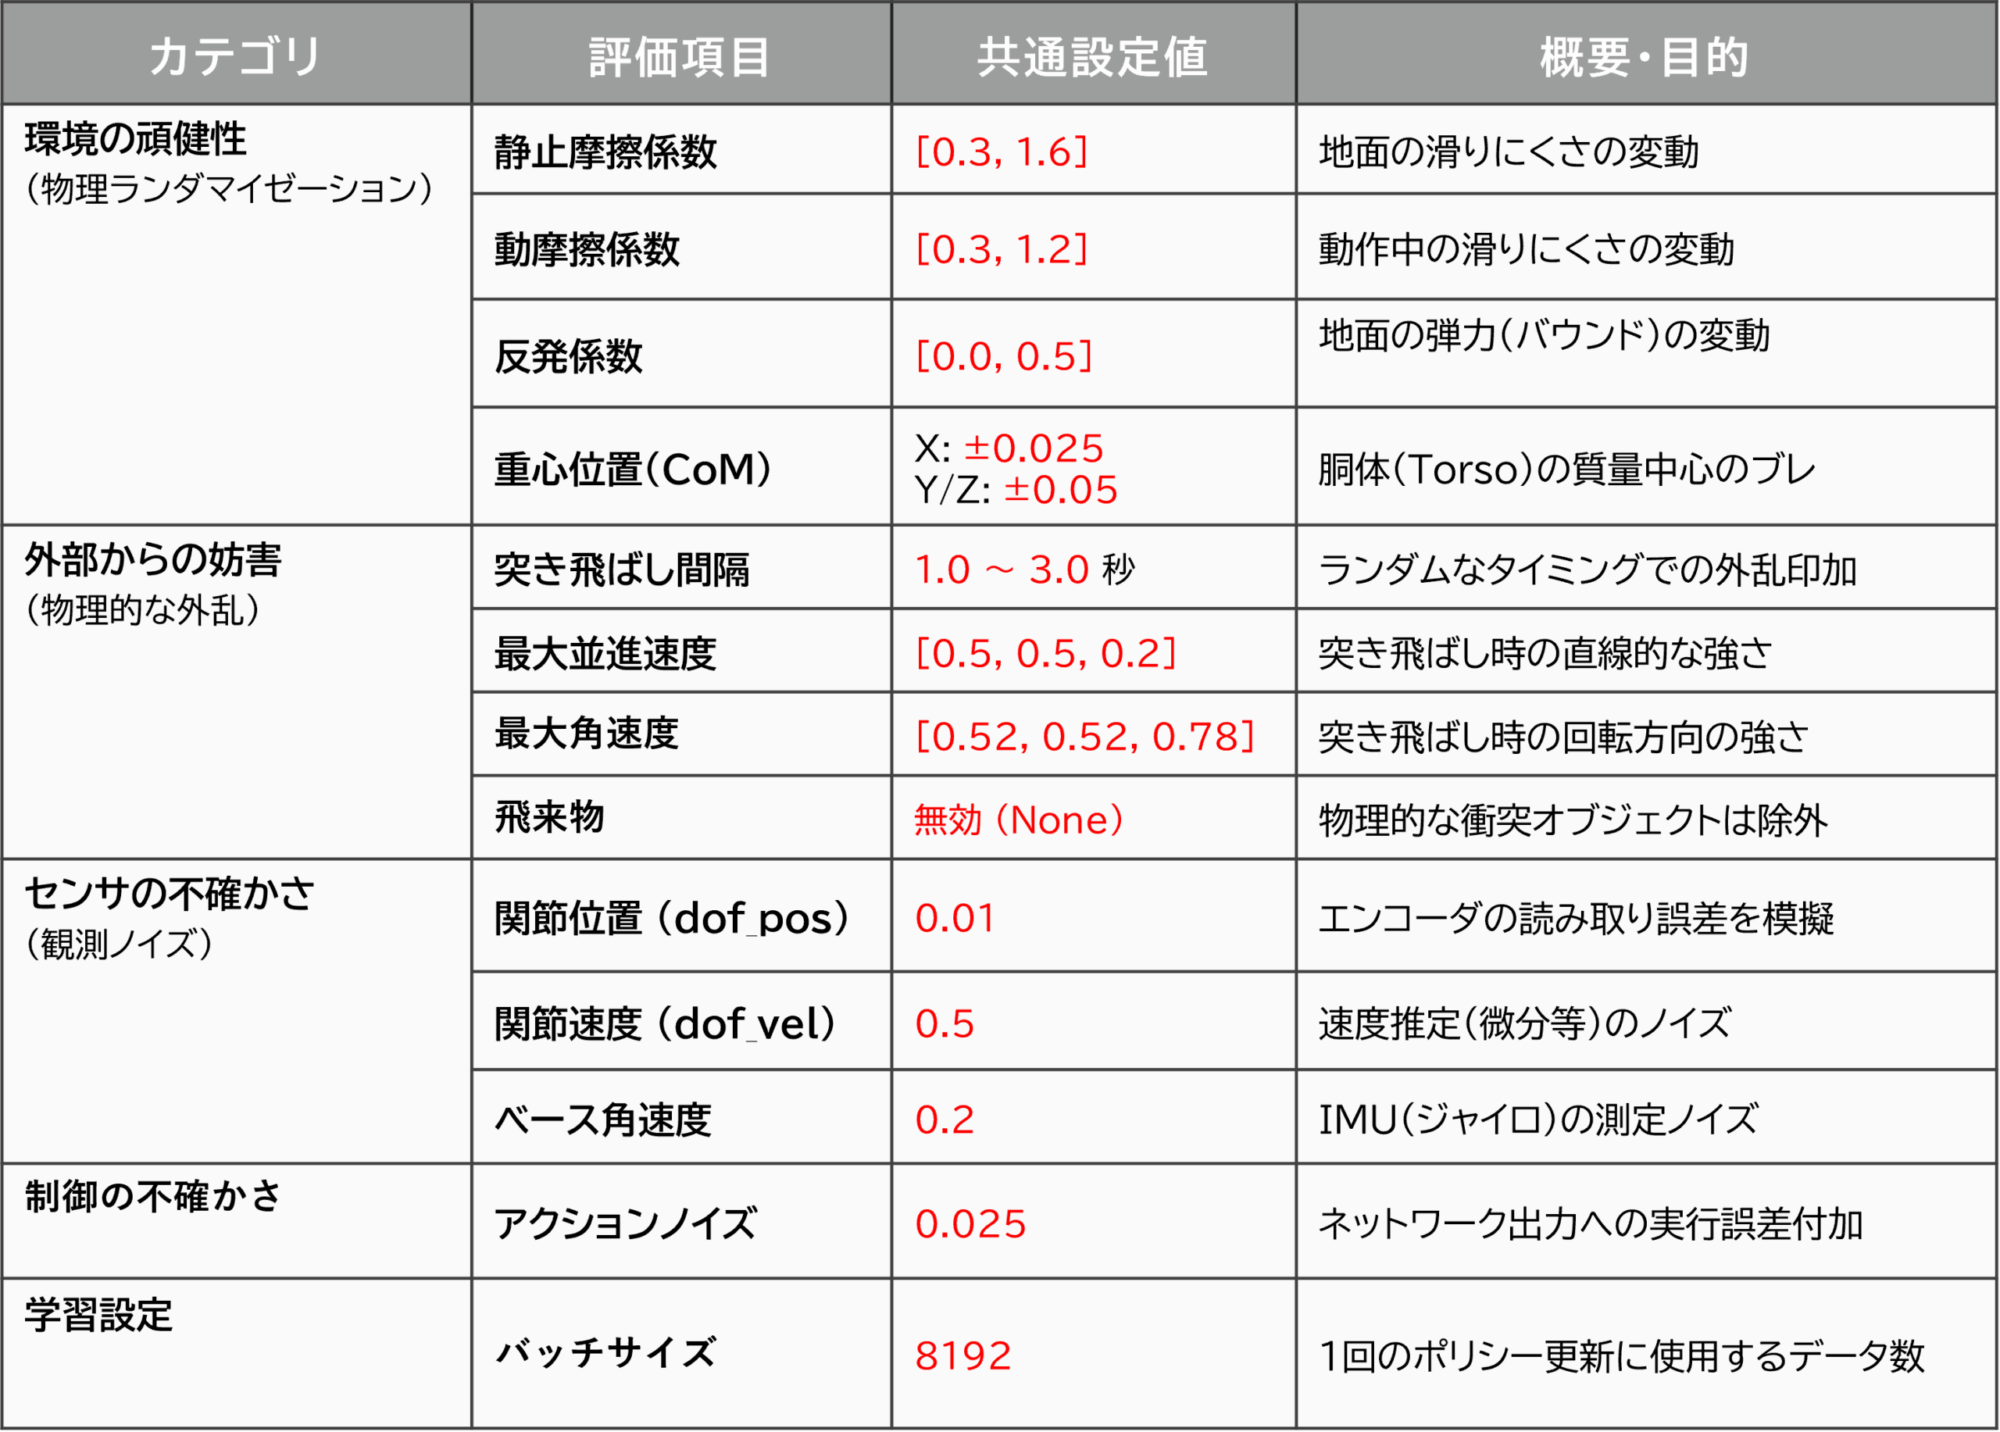
本検討では、Unitree G1(ヒューマノイドロボット)を対象に、全身制御における各学習アルゴリズム(Fast-SAC / PPO)の学習性能を公平に比較するため、学習環境およびドメインランダマイゼーション(DR)の条件を厳密に統一して実験を行いました。
3-1 評価タスクと使用データ
■ 対象ロボット:
Unitree G1(29自由度)
■ 評価タスク:
全身運動の追従性能を評価するため、大規模モーションデータセット「AMASS」の中から、比較的激しく全身を連動させる必要のある「scamper(駆け足・這い回る動作)」をベンチマークタスクとして選定しました。
■ 学習アルゴリズム:
Fast-SAC(実装基盤: holosoma)、PPO(実装基盤: ProtoMotions)
3-2 共通実験条件
物理ランダマイゼーション、外乱、各種ノイズ、およびハイパーパラメータの設定は以下の通り共通化しました。
4.結果(定量評価)
本検証についてはFast-SAC(holosoma)がPPO(ProtoMotions)に対して学習速度、タスク生存時間、追従精度のすべての指標において優れた性能を示しました。
以下に、時間(Time [s])に対する3つの主要指標の推移を示します。
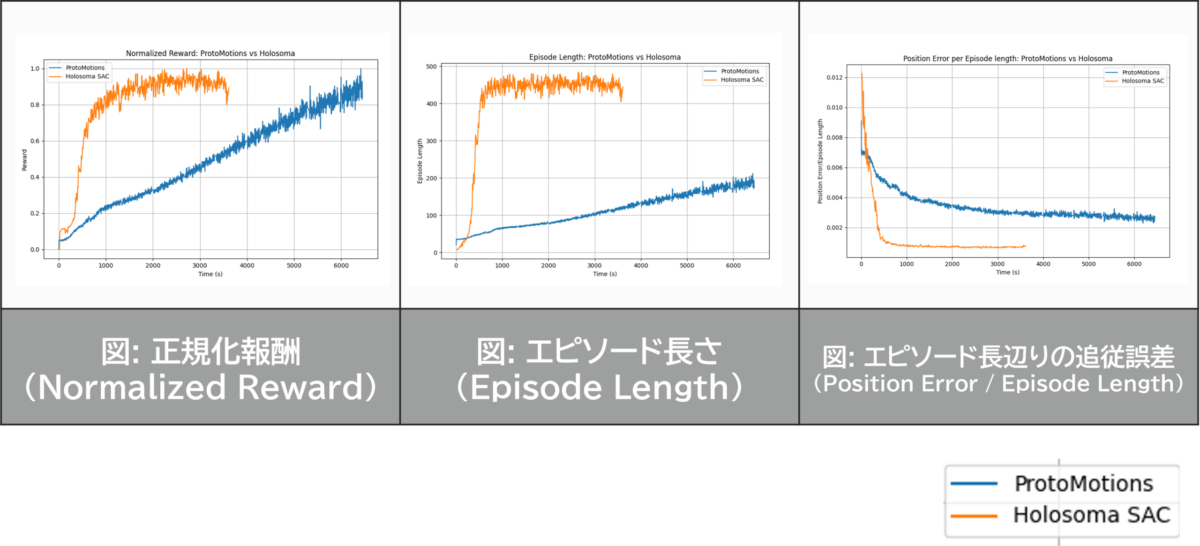
4-1 正規化報酬(Normalized Reward)の推移
■ Fast-SAC(holosoma):
開始直後から非常に早い立ち上がりを見せ、1,000秒未満の段階で報酬が最大値(約0.9〜1.0)付近に達し、その後も安定して高水準を維持しています。
■ PPO(ProtoMotions):
報酬は緩やかに上昇し続けているものの、6,000秒が経過した時点でも最大値には達しておらず、収束までに膨大な時間を要する傾向が見られます。
4-2 エピソード長さ(Episode Length)の推移
■ Fast-SAC(holosoma):
報酬の立ち上がりと同期して、500秒付近を境にエピソード長さが上限(約450〜480ステップ)へと急激に到達しています。
これは、早い段階で「転倒しない全身制御」を獲得できていることを意味します。
■ PPO(ProtoMotions):
6,000秒以上経過してもエピソード長さは200ステップ未満にとどまっており、DR(ドメインランダマイゼーション)による外乱や環境変化に対して耐えきれず、早期に転倒を繰り返していることが分かります。
4-3 エピソード長辺りの追従誤差(Position Error / Episode Length)
■ Fast-SAC(holosoma):
初期の誤差は大きいものの、500秒を過ぎた時点で一気に誤差が減少し、0.001以下の高い追従精度を維持するようになります。
■ PPO(ProtoMotions):
時間の経過とともに誤差は減少傾向にあるものの、6,000秒以上かけても 0.002〜0.003 付近にとどまっており、holosomaほどの精密な追従には至っていません。
4-4 定量評価のまとめ
以上の結果から、今回の設定(G1モデル × scamper動作 × AMP学習)においては、Fast-SACがPPOに対して高い学習効率と高い制御性能を持つことが確認されました。
5. 考察・まとめ
本検討では、ヒューマノイドロボット「Unitree G1」を用いた全身制御(WBC)において、 各学習アルゴリズム(Fast-SAC / PPO)の性能を、代表的な実装基盤を比較・評価しました。
◆ わかったこと
今回の実験を通じて、以下の知見が得られました。
■ Fast-SACの優位性:
Fast-SACは、学習開始から1,000秒未満という極めて早い段階で報酬を収束させ、エピソード長を最大化(=転倒しない制御を獲得)することに成功しました。
追従誤差の減少速度および最終的な精度においても、PPOよりも優れていました。
■ アルゴリズムとタスク設計の重要性:
今回の検証では学習環境やドメインランダマイゼーションの条件を統一した一方で、各フレームワークがデフォルトで保持している報酬設計(各報酬項の重みやシェーピング関数)をそのまま採用しています。
そのため、観測された学習速度や性能差には、フレームワーク側の報酬設計のチューニング度合いが寄与している可能性があります。
■ 環境変化への頑健性:
突き飛ばし外乱やセンサー・制御ノイズが多数存在するDR環境下において、 Fast-SACは早期にロバストなポリシーを構築できるため、高品質な学習データを継続して蓄積できるという好循環を生み出していました。
6.Sim2Sim検証 (holosoma)
定量評価において高い性能を示したholosomaを用い、シミュレータ間転移(Sim2Sim)の検証を行いました。
具体的には、学習を行った「Isaac Sim」から、物理エンジンの特性が異なる「MuJoCo環境」へとポリシーを転移させ、Unitree G1の挙動を検証しました。
以下は、MuJoCo環境上で「scamper」動作の転移に成功した際の検証動画です。
◆ 今後の課題、実装におけるTips・注意点
実際にSim2Simの環境を構築し、ポリシーを転移させるにあたって、以下2点の実践的なノウハウ・課題が明らかになりました。
■ 初期フレーム(1フレーム目)の接地状態の重要性
ターゲットとなるモーションの「1フレーム目」において、ロボットの両足が地面としっかりと接地していない場合、MuJoCo環境に移行した直後の初期ドロップ(落下)時の衝撃やバランス崩壊により、スタート直後に転倒してしまう問題が発生しました。
【対策】
本検証では、モーションデータのスタート時のフレームを「両足が完全に接地している瞬間」のフレームへ変更することで、転倒を回避し安定したスタートを実現しました。
■ モーション終了後の制御オフによる転倒(今後の課題)
指定したモーションデータが最後まで再生され終了した直後、全身の制御がオフ(脱力状態)になってしまい、ロボットがそのまま自重で倒れてしまう挙動が確認されています。
【現状のステータス】
こちらは現時点で未対応の課題であり、モーション終了後もアイドリング状態(静止起立姿勢)を維持するような制御の切り替え、またはポリシーの拡張が今後の実装において必要となります。
おわりに
今回の条件では、holosomaが学習効率と追従性能で良好な結果を示し、MuJoCoへのSim2Sim転移も確認できました。
一方、動作開始時の接地状態や終了後の姿勢維持には課題が残りました。
今後は、開始・終了時の安定性を改善するとともに、異なる動作や外乱、学習設定での再現性を検証予定です。
クフウシヤでは、こうした評価を用途に応じた技術選定につなげ、実機・現場での活用を見据えたフィジカルAI開発を進めていきます。
◆ 参考URL
■ Amazon FAR Lab – holosoma: https://github.com/amazon-far/holosoma
■ NVIDIA Labs – ProtoMotions: https://github.com/NVlabs/ProtoMotions
関連動画

【Unitree G1×LeRobot】模倣学習を実機検証!unitree_lerobotによるアーム動作の学習・推論手順(ACT / π0.5比較)
【※この記事は2026年7月時点の情報に基づきます。】 はじめに ◆ 背景今回は、Unitreeのヒューマノイドロボット「G1」で模倣学習を行えるオープンソースプロジェクト「unitree_lerobot」を試してみました。 模倣…
詳細を見る
GR00TのGear Sonicを使って、Picoで全身トラッキングしてみた【G1実機編】
【2026年4月時点の記事です】はじめに:クフウシヤでは、G1を用いたフィジカルAIの研究開発をしています。 今回は NVIDIA の GR00T-WholeBodyControl に含まれるGEAR-SONIC と、 VRヘッドセット Pico を組み合…
詳細を見る
GR00TのGear Sonicを使って、Picoで全身トラッキングしてみた【シミュレーション(MuJoCo)編】
【2026年4月時点の記事です】はじめに:クフウシヤでは、G1を用いたフィジカルAIの研究開発をしています。 今回は NVIDIA の GR00T-WholeBodyControl に含まれる GEAR-SONIC と、VRヘッドセット Pico を組み合わ…
詳細を見る